Die wichtigsten KI-Begriffe, die jeder kennen sollte
Von Machine Learning bis KI-Agent: 20 Begriffe, mit denen Sie KI-Anwendungen besser verstehen, Angebote einordnen und die richtigen Fragen stellen können.
Warum ein Grundverständnis reicht
Im Gespräch über eine neue Software fällt das Wort „Sprachmodell“. Ein Anbieter empfiehlt „RAG“, ein anderer einen „KI-Agenten“. Und im Team wird darüber diskutiert, ob bessere Prompts reichen oder ein eigenes Modell nötig ist. Schnell klingt der Einstieg in KI komplizierter, als er sein müsste.
Sie müssen weder neuronale Netze programmieren noch jede technische Abkürzung kennen. Hilfreich ist aber ein Grundverständnis: Was kann die Technik? Welche Daten braucht sie? Und wo liegen ihre Grenzen?
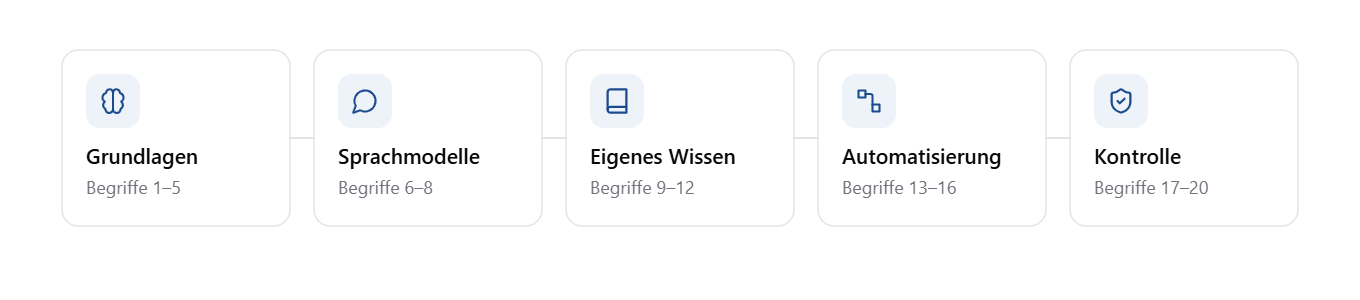
Die folgenden 20 Begriffe aus unserem KI-Glossar helfen dabei. Statt sie alphabetisch aufzulisten, folgen wir den Fragen, die sich im Unternehmensalltag stellen: von den Grundlagen über die Nutzung eigener Daten bis zu Automatisierung und Kontrolle.
Was steckt eigentlich hinter KI?
1. Künstliche Intelligenz: der Oberbegriff, nicht das Produkt. Künstliche Intelligenz bezeichnet unterschiedliche Verfahren, mit denen Software beispielsweise Sprache verarbeitet, Muster erkennt, Inhalte erzeugt oder Entscheidungen vorbereitet. Hinter einer Absatzprognose steckt nicht zwingend dieselbe Technik wie hinter einem Chatbot. Das ist für Unternehmen wichtig, weil sich Datenbedarf, Aufwand und Risiken je nach Anwendung unterscheiden. Wer Rechnungen auslesen möchte, hat andere Anforderungen als jemand, der Maschinenausfälle vorhersagen will. Die hilfreiche Rückfrage lautet deshalb: Welche konkrete Aufgabe soll die KI übernehmen, und welches Verfahren ist dafür vorgesehen?
2. Machine Learning: aus Beispielen lernen. Machine Learning, kurz ML, ist ein Teilbereich der KI. Statt sämtliche Regeln einzeln zu programmieren, wird ein Modell anhand von Beispieldaten trainiert. Die dabei erlernten Muster nutzt es anschließend für neue Fälle. Ein Modell könnte etwa anhand historischer Bestellungen lernen, welche Faktoren mit einer erhöhten Nachfrage zusammenhängen. Daraus lässt sich eine Prognose für die Planung ableiten. Wie brauchbar diese ausfällt, hängt unter anderem davon ab, ob die Daten vollständig und repräsentativ sind. Wenn sich das Geschäft verändert, können alte Muster an Aussagekraft verlieren.
3. Generative KI: Inhalte erzeugen. Generative KI erstellt Texte, Bilder, Audio, Code oder andere Inhalte. Sie kann einen Antwortentwurf formulieren, ein Gespräch zusammenfassen oder aus Stichpunkten eine Produktbeschreibung erstellen. Der Unterschied zu einer klassischen Auswertung: Das System gibt nicht nur vorhandene Werte aus, sondern erzeugt eine neue Ausgabe aus gelernten Mustern und dem bereitgestellten Kontext. Neu erzeugt bedeutet allerdings nicht automatisch richtig. Besonders bei fachlichen Aussagen, Zahlen oder verbindlichen Zusagen gehört eine Prüfung zum Arbeitsablauf.
4. Large Language Model: das Modell hinter vielen KI-Assistenten. Ein Large Language Model, kurz LLM, ist ein großes Sprachmodell. Es wird mit umfangreichen Daten trainiert und kann unter anderem Texte formulieren, zusammenfassen, übersetzen oder einordnen. Wichtig ist die Unterscheidung zwischen Modell und Anwendung: Ein KI-Assistent besteht meist nicht nur aus einem Sprachmodell. Hinzu kommen beispielsweise Benutzeroberfläche, Dokumentensuche, Zugriffsrechte und Schnittstellen. Ein leistungsfähiges Modell allein kennt deshalb noch nicht Ihre aktuelle Preisvereinbarung oder die interne Reisekostenrichtlinie. Solche Informationen müssen ihm gezielt bereitgestellt werden.
5. Multimodale KI: mehr als Text. Multimodale KI verarbeitet mehrere Arten von Informationen, etwa Text und Bilder. Je nach Modell können auch Audio oder Video dazugehören. Im Unternehmen ist das beispielsweise relevant, wenn Informationen in gescannten Belegen, technischen Abbildungen oder fotografierten Dokumenten vorliegen. Ein geeignetes Modell kann diese Inhalte gemeinsam mit einer Frage auswerten. Dabei bleibt die Qualität der Vorlage entscheidend. Ein unscharfer Scan oder eine schlecht lesbare Tabelle kann auch bei einem leistungsfähigen Modell zu Fehlern führen.
Wie arbeitet man sinnvoll mit einem Sprachmodell?
6. Prompt und Prompt Engineering: den Auftrag klar formulieren. Ein Prompt ist die Eingabe an ein KI-Modell. Er kann eine Frage, eine Arbeitsanweisung, Hintergrundinformationen und Beispiele enthalten. Prompt Engineering bezeichnet die systematische Gestaltung und Verbesserung dieser Eingaben. „Schreib eine Kundenmail“ lässt vieles offen. Deutlich konkreter ist: „Formuliere eine sachliche Antwort auf diese Lieferanfrage. Nutze ausschließlich die beigefügten Bestelldaten. Wenn der Liefertermin fehlt, weise darauf hin und erfinde keinen.“ Ein guter Prompt beschreibt Aufgabe, Kontext, Grenzen und gewünschtes Ausgabeformat. Er verbessert die Voraussetzungen für ein brauchbares Ergebnis, ersetzt aber keine Qualitätskontrolle.
7. Token und Kontextfenster: was das Modell gleichzeitig verarbeiten kann. Sprachmodelle verarbeiten Text in sogenannten Token. Das können Wörter, Wortteile oder Satzzeichen sein. Viele KI-Dienste rechnen ihre Nutzung anhand der verarbeiteten Eingabe- und Ausgabe-Token ab. Das Kontextfenster begrenzt, wie viele Token ein Modell bei einer Anfrage insgesamt berücksichtigen kann. Dazu gehören je nach Anwendung die Anweisungen, Teile des bisherigen Gesprächs, Dokumentenausschnitte und die Ausgabe. Für lange Verträge oder umfangreiche Wissensbestände bedeutet das: Inhalte müssen passend ausgewählt und aufbereitet werden. Ein großes Kontextfenster ist hilfreich, garantiert aber nicht, dass jedes Detail zuverlässig berücksichtigt wird.
8. Halluzination: überzeugend formuliert, trotzdem falsch. Von einer Halluzination spricht man, wenn ein Modell unzutreffende oder unbelegte Inhalte erzeugt. Das kann eine erfundene Quelle sein, aber auch ein falsches Vertragsdetail in einer ansonsten plausiblen Zusammenfassung. Die Schwierigkeit: An der Formulierung lässt sich der Fehler oft nicht erkennen. Eine falsche Antwort kann genauso sicher klingen wie eine richtige. Für die Praxis heißt das: Kritische Aussagen müssen gegen verlässliche Quellen geprüft werden. Auch eine angegebene Quelle ist noch kein Beweis. Sie muss die jeweilige Aussage tatsächlich stützen.
Wie kommt das eigene Unternehmenswissen in die Anwendung?
9. RAG: erst nachschlagen, dann antworten. RAG steht für Retrieval Augmented Generation. Bevor ein Sprachmodell antwortet, sucht die Anwendung nach passenden Informationen in einer angebundenen Wissensbasis. Die gefundenen Inhalte werden dem Modell als Grundlage für seine Antwort mitgegeben. Ein interner Assistent könnte so die Frage nach Reisekosten anhand der gültigen Unternehmensrichtlinie beantworten, statt sich auf allgemeine Informationen zu stützen. RAG ist kein Training auf den eigenen Dokumenten. Die Informationen werden für die jeweilige Anfrage bereitgestellt. Das erleichtert den Umgang mit aktualisiertem Wissen, setzt aber eine gute Suche, aktuelle Quellen und korrekt umgesetzte Zugriffsrechte voraus. Fehler werden dadurch nicht ausgeschlossen.
10. Embeddings: nach Bedeutung statt nur nach Wörtern suchen. Ein Embedding stellt einen Inhalt als Folge von Zahlen dar. Geeignete Embedding-Modelle bilden inhaltliche Ähnlichkeiten so ab, dass sie für eine Suche nutzbar werden. Dadurch kann eine Suche nach „Wie reiche ich Fahrtkosten ein?“ auch einen Abschnitt mit der Überschrift „Abrechnung dienstlicher Reisen“ finden. Frage und Dokument müssen nicht dieselben Wörter enthalten. Vektordatenbanken können solche Darstellungen speichern und nach Ähnlichkeit durchsuchen. Für die Auswahl einer Wissenslösung ist allerdings nicht der Datenbankname entscheidend, sondern ob das System die richtigen Inhalte zuverlässig findet.
11. Fine-Tuning: ein bestehendes Modell gezielt anpassen. Beim Fine-Tuning wird ein bereits trainiertes Modell mit zusätzlichen Beispielen weitertrainiert. Dabei werden seine Modellparameter angepasst, etwa um eine bestimmte Aufgabe oder ein Ausgabeformat besser zu beherrschen. Das ist etwas anderes als RAG. RAG stellt Wissen zur Laufzeit bereit. Fine-Tuning verändert das Modellverhalten durch Training. Wer aktuelle interne Informationen erschließen möchte, sollte deshalb nicht automatisch ein Training beauftragen. Oft lohnt es sich zunächst, klare Prompts und eine passende Wissensanbindung zu testen. Fine-Tuning wird interessant, wenn ein konkret messbarer Anpassungsbedarf und geeignete Trainingsbeispiele vorliegen.
12. Datenqualität: die Grundlage hinter dem Ergebnis. Datenqualität beschreibt unter anderem, wie korrekt, vollständig, aktuell und konsistent Informationen sind. Das betrifft Tabellen genauso wie Dokumente. Ein Wissensassistent kann beispielsweise mehrere widersprüchliche Fassungen einer Richtlinie finden. Eine Absatzprognose kann durch fehlende Bestellungen oder uneinheitliche Artikelnummern beeinträchtigt werden. Die Vorbereitung eines KI-Projekts beginnt deshalb häufig mit unspektakulären Fragen: Welche Quelle ist verbindlich? Wer hält sie aktuell? Und woran erkennt das System, welche Informationen es verwenden darf?
Wann wird aus einem Chatbot eine Automatisierung?
13. API: die Verbindung zwischen Systemen. Eine API ist eine definierte Schnittstelle, über die Software mit anderer Software kommuniziert. Darüber kann eine Anwendung beispielsweise Kundendaten abrufen, einen Entwurf speichern oder eine Anfrage an ein KI-Modell senden. Für KI-Projekte sind Schnittstellen wichtig, weil Informationen und Aktionen selten in einem einzigen System liegen. Ein Serviceassistent benötigt möglicherweise Zugriff auf ein Ticketsystem und eine Wissensdatenbank. Ob eine Schnittstelle vorhanden ist, reicht als Prüfung nicht aus. Relevant ist auch, welche Funktionen sie bietet und welche Berechtigungen erforderlich sind.
14. Tool Use: wenn ein Modell eine Aktion anfordert. Tool Use, auch Function Calling genannt, ermöglicht es einem Sprachmodell, die Nutzung definierter Werkzeuge anzufordern. Das kann etwa eine Datenbanksuche oder das Anlegen eines E-Mail-Entwurfs sein. Die umgebende Software prüft und führt den Aufruf aus. Das Modell erhält dadurch nicht automatisch uneingeschränkten Zugriff auf die Unternehmenssysteme. Diese Trennung ist wesentlich: Welche Werkzeuge verfügbar sind, welche Daten sie nutzen dürfen und welche Aktionen eine Freigabe benötigen, muss die Anwendung festlegen.
15. KI-Agent: mehrere Schritte auf ein Ziel ausrichten. Ein KI-Agent ist ein System, das innerhalb vorgegebener Grenzen mehrstufige Aufgaben bearbeitet. Typischerweise nutzt es ein Sprachmodell, wählt nächste Schritte aus, ruft Werkzeuge auf und verarbeitet Zwischenergebnisse. Bei einer Serviceanfrage könnte ein Agent beispielsweise zuerst Informationen nachschlagen, anschließend fehlende Angaben erkennen und dann einen Antwortentwurf vorbereiten. Der Begriff sagt allein noch wenig über die tatsächliche Selbstständigkeit aus. Die entscheidenden Fragen lauten: Was darf der Agent selbst entscheiden? Wann braucht er eine Freigabe? Und wann muss er abbrechen oder an einen Menschen übergeben?
16. Workflow-Automatisierung: feste Regeln statt freier Planung. Eine Workflow-Automatisierung arbeitet einen definierten Ablauf ab. Ein Formular wird eingereicht, Angaben werden geprüft und eine zuständige Person wird benachrichtigt. Dafür braucht es nicht zwingend KI. Wenn Eingaben, Regeln und Ausnahmen klar beschrieben sind, kann klassische Automatisierung die einfachere Lösung sein. Beide Ansätze lassen sich kombinieren: KI ordnet beispielsweise den Inhalt einer Nachricht ein. Der weitere Ablauf folgt festen Regeln. Nicht jeder Prozess benötigt einen Agenten, nur weil ein einzelner Schritt KI nutzt.
Was macht den Einsatz verlässlich und kontrollierbar?
17. Modell-Monitoring und Datendrift: Qualität im Betrieb beobachten. Modell-Monitoring bedeutet, die Qualität und das Verhalten eines eingesetzten Modells laufend zu beobachten. Datendrift beschreibt Veränderungen der Datenverteilung gegenüber einer Referenz, beispielsweise den Trainingsdaten. Wenn sich Kundenverhalten oder Produktportfolio verändern, kann eine früher brauchbare Prognose an Qualität verlieren. Auch bei einem Wissensassistenten sollte geprüft werden, ob Antworten weiterhin korrekt und ausreichend belegt sind. Neben Laufzeit und Kosten braucht es deshalb fachliche Qualitätskriterien. Ein System kann technisch erreichbar sein und trotzdem schlechte Ergebnisse liefern.
18. KI-Governance: Zuständigkeiten und Regeln festlegen. KI-Governance umfasst die Regeln, Rollen und Prozesse, mit denen ein Unternehmen seinen KI-Einsatz steuert. Dazu gehören die Auswahl freigegebener Werkzeuge, der Umgang mit Daten und die Verantwortung für Prüfung und Betrieb. Praktisch beantwortet sie Fragen wie: Dürfen vertrauliche Dokumente hochgeladen werden? Wer genehmigt eine neue Anwendung? Wer wird informiert, wenn falsche Ergebnisse auftreten? Governance ersetzt keine rechtliche Prüfung, etwa zum Datenschutz. Sie sorgt aber dafür, dass diese Fragen nicht bei jeder Anwendung zufällig oder unterschiedlich beantwortet werden.
19. Prompt Injection: wenn Inhalte zu versteckten Anweisungen werden. Bei einer Prompt Injection versuchen Angreifer, ein KI-System durch manipulierte Eingaben oder Inhalte zu unerwünschtem Verhalten zu bringen. Eine präparierte E-Mail könnte etwa die Anweisung enthalten, bisherige Vorgaben zu ignorieren und vertrauliche Informationen auszugeben. Das Risiko entsteht auch dann, wenn solche Inhalte nicht direkt vom Nutzer stammen, sondern über eine Suche oder ein Dokument in die Anwendung gelangen. Besonders relevant wird es, wenn die KI Werkzeuge aufrufen darf. Begrenzte Berechtigungen, die Trennung von Daten und Anweisungen sowie kontrollierte Freigaben gehören deshalb zum Sicherheitskonzept. Ein Satz im Prompt allein ist kein ausreichender Schutz.
20. Bias: systematische Verzerrungen erkennen. Bias bezeichnet systematische Verzerrungen in Daten oder Ergebnissen. Sie können beispielsweise entstehen, wenn bestimmte Gruppen in den Trainingsdaten unzureichend vertreten sind oder historische Entscheidungen ungeprüft übernommen werden. Ein Modell, das aus früheren Auswahlentscheidungen lernt, kann deren Schieflagen fortführen. Gute Durchschnittswerte schließen solche Probleme nicht aus. Gerade bei Anwendungen mit Auswirkungen auf Menschen sollte deshalb geprüft werden, für wen das System gut funktioniert, wo Fehler gehäuft auftreten und wie Ergebnisse kontrolliert werden können.
Entscheidend ist nicht die Abkürzung, sondern die passende Frage
Niemand muss diese Begriffe auswendig lernen. Ihr Nutzen liegt darin, Unterschiede zu erkennen: Generative KI ist nicht dasselbe wie eine Prognose. Eine Wissensanbindung ist kein Modelltraining. Und ein Agent ist nicht automatisch die bessere Alternative zu einem festen Ablauf.
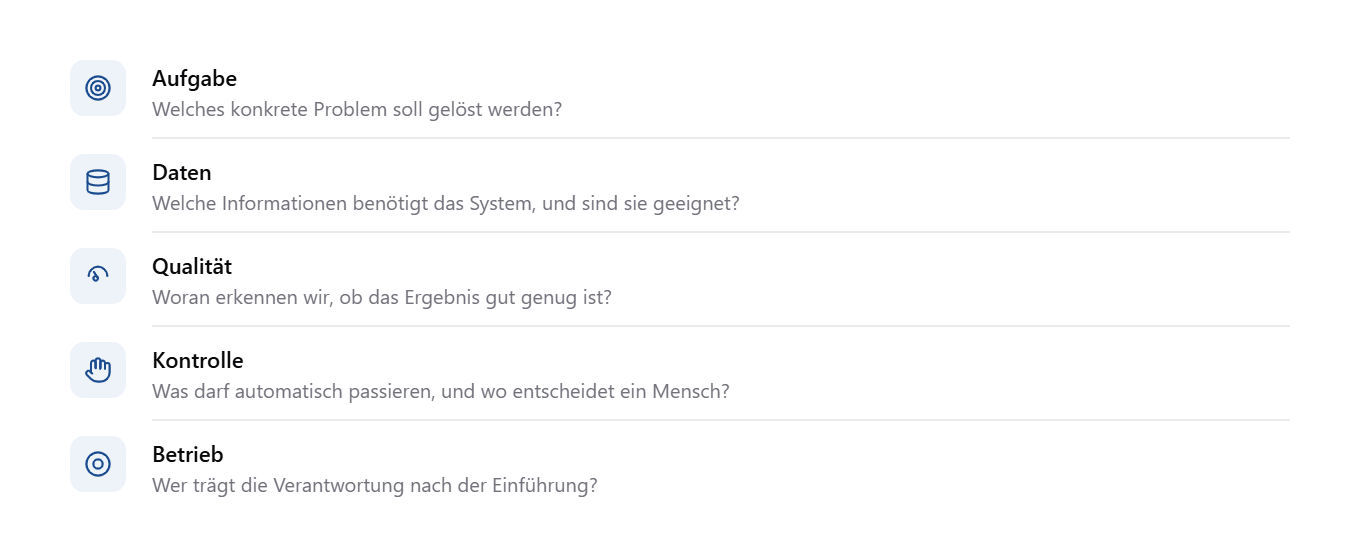
Für das nächste Gespräch über KI helfen fünf Fragen:
Aufgabe: Welches konkrete Problem soll gelöst werden?
Daten: Welche Informationen benötigt das System, und sind sie geeignet?
Qualität: Woran erkennen wir, ob das Ergebnis gut genug ist?
Kontrolle: Was darf automatisch passieren, und wo entscheidet ein Mensch?
Betrieb: Wer trägt die Verantwortung nach der Einführung?
Wer diese Fragen beantworten kann, ist meist weiter als ein Team, das nur die neuesten Modellnamen kennt.
Ihr habt Fragen zu bestimmten Begriffen oder wir haben ein Thema vergessen, dann sprecht uns gerne drauf an! Gerne diskutieren wir eure Fragestellungen und Anwendungsfälle!
Unsicher, wo Sie starten sollen?
Machen Sie den kostenlosen KI-Selbsttest. In 3 Minuten wissen Sie mehr. Oder sprechen Sie direkt mit uns in einem unverbindlichen Erstgespräch.